Noch komplexer wird die Eigentumsfrage beim trainierten Modell. Ein Large Language Model umfasst wirtschaftlich nicht nur Softwarecode, sondern auch Architektur, Trainingsverfahren und -daten, Modellgewichte, Fine-Tuning-Daten, Embeddings, Prompts, System Instructions und Knowledge Bases. Diese Komponenten können unterschiedlichen Akteuren zugeordnet sein. Code kann urheberrechtlich geschützt, ein Trainingsverfahren patentierbar und ein Datensatz ein Geschäftsgeheimnis sein. Modellgewichte werden häufig über Lizenzen, Zugangskontrollen und Geheimhaltung abgesichert.
Das zeigt sich bei Open-Weight-Modellen wie Qwen oder DeepSeek. Herunterladbare Modellgewichte sind nicht automatisch rechtlich frei verfügbar. Maßgeblich sind die Lizenzbedingungen für Nutzung, Veränderung, Weitergabe und kommerzielle Verwertung. Bei Kooperationen, Joint Ventures oder M&A muss deshalb geklärt werden, welche Komponenten der Anbieter selbst kontrolliert, welche Open Source oder lizenziert sind und welche Rechte an Trainingsdaten und Outputs bestehen.
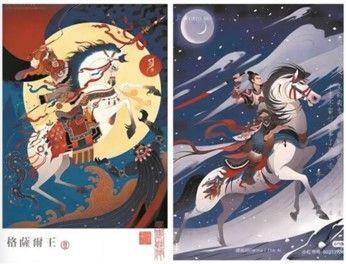
Die KI steht auf der Anklagebank. Vier Künstler haben das KI-Malmodell Trik von Xiaohongshu wegen unerlaubter Verwendung ihrer Originalwerke verklagt. Das Pekinger Internetgericht hat die Klage angenommen. Das Bild zeigt den Vergleich des Originals eines der Künstler (links) und des von Trik generierten Kunstwerks (rechts).
(Bild: Yangcheng Evening News)
Ein zusätzliches Problem entsteht beim Fine-Tuning. Spezialisiert ein europäischer Maschinenbauer ein chinesisches Basismodell mit eigenen Wartungsberichten und technischen Dokumentationen, entstehen drei wirtschaftliche Assets: das Basismodell, der proprietäre Datensatz und das Fine-Tuned Model. Verträge müssen klären, ob der Anbieter Fine-Tuning-Daten speichern und für sein Basismodell nutzen darf, wem Adapter oder veränderte Gewichte gehören, ob der Kunde sie exportieren kann und was bei Vertragsende geschieht. „Customer retains ownership of its data“ reicht nicht aus, wenn abgeleitete Parameter oder aggregiertes Wissen beim Provider verbleiben.
Auch beim Output entwickelt China bemerkenswerte Rechtsprechung. Im Verfahren Li Yunkai gegen Liu vor dem Beijing Internet Court hatte der Kläger mit Stable Diffusion durch zahlreiche Prompts, Parameteränderungen und Iterationen ein Bild erzeugt. Das Gericht erkannte Urheberrechtsschutz an: Entscheidend war nicht die KI, sondern die menschliche schöpferische Leistung. Das Modell könne kein Autor sein; der Nutzer habe jedoch genügend individuelle Entscheidungen getroffen.
China schützt damit nicht pauschal KI-Werke, sondern KI-unterstützte Ergebnisse mit ausreichender menschlicher Originalität. Den Gegenpol bildet der Butterfly-Chair-Fall: Ein mit Midjourney entworfener transparenter Stuhl erhielt nicht den beanspruchten Schutz, weil einfache Prompts und Parametereinstellungen keine hinreichend nachvollziehbare schöpferische Leistung belegten und der Entstehungsprozess nicht ausreichend dokumentiert war. Unternehmen sollten daher Prompts, Iterationen, Auswahlentscheidungen und Bearbeitungsschritte dokumentieren.
Auch im Patentrecht hält China am Erfordernis eines menschlichen Erfinders fest. Nach den Patent Examination Guidelines der China National Intellectual Property Administration (CNIPA) muss der Erfinder eine natürliche Person sein, die einen schöpferischen Beitrag zu den wesentlichen Merkmalen der Erfindung geleistet hat. Ein KI-System selbst kann nicht als Erfinder benannt werden. Bei KI-gestützten Entwicklungsprozessen muss daher insbesondere nachvollziehbar sein, welche natürlichen Personen solche erfinderischen Beiträge geleistet haben. Davon zu unterscheiden ist die Inhaberschaft am Patent: Erfinder und späterer Patentinhaber müssen nicht identisch sein, etwa bei Diensterfindungen.
KI-Recht in China: Verletzung fremder Rechte durch schutzfähige KI
Ein KI-Output kann selbst schutzfähig sein und zugleich fremde Rechte verletzen. Im ersten chinesischen Ultraman-AIGC-Fall erzeugte ein Bildsystem Bilder, die der geschützten Figur erheblich ähnelten. Das Guangzhou Internet Court nahm eine Verletzung von Vervielfältigungs- und Bearbeitungsrechten an und sprach unter anderem 10.000 RMB Schadensersatz zu. Damit sind stets zwei Fragen zu prüfen: Bestehen eigene Rechte am Output, und verletzt dieser zugleich ältere Rechte Dritter? Auch ein geschützter KI-Werbeclip kann Marken-, Urheber-, Design- oder Persönlichkeitsrechte verletzen.
Dass die Risiken nicht an Chinas Grenzen enden, zeigt erneut MiniMax. Disney, Universal und Warner Bros. Discovery verklagten den Anbieter 2025 in Kalifornien. Im Mittelpunkt stehen über Hailuo AI erzeugte Darstellungen von Darth Vader, Minions oder Superman sowie Vorwürfe zur Verwendung geschützten Materials. Chinesische Anbieter exportieren mit ihren Modellen damit auch IP-Risiken: Eine in China ungeklärte Trainingspraxis kann in den USA oder Europa anders bewertet werden. Europäische Unternehmen, die chinesische Modelle integrieren, übernehmen einen Teil dieses Risikos in ihre Lieferkette.
Stand: 16.12.2025
Es ist für uns eine Selbstverständlichkeit, dass wir verantwortungsvoll mit Ihren personenbezogenen Daten umgehen. Sofern wir personenbezogene Daten von Ihnen erheben, verarbeiten wir diese unter Beachtung der geltenden Datenschutzvorschriften. Detaillierte Informationen finden Sie in unserer Datenschutzerklärung.
Einwilligung in die Verwendung von Daten zu Werbezwecken
Ich bin damit einverstanden, dass die WIN-Verlag GmbH & Co. KG, Chiemgaustraße 148, 81549 München einschließlich aller mit ihr im Sinne der §§ 15 ff. AktG verbundenen Unternehmen (im weiteren: Vogel Communications Group) meine E-Mail-Adresse für die Zusendung von redaktionellen Newslettern nutzt. Auflistungen der jeweils zugehörigen Unternehmen können hier abgerufen werden.
Der Newsletterinhalt erstreckt sich dabei auf Produkte und Dienstleistungen aller zuvor genannten Unternehmen, darunter beispielsweise Fachzeitschriften und Fachbücher, Veranstaltungen und Messen sowie veranstaltungsbezogene Produkte und Dienstleistungen, Print- und Digital-Mediaangebote und Services wie weitere (redaktionelle) Newsletter, Gewinnspiele, Lead-Kampagnen, Marktforschung im Online- und Offline-Bereich, fachspezifische Webportale und E-Learning-Angebote. Wenn auch meine persönliche Telefonnummer erhoben wurde, darf diese für die Unterbreitung von Angeboten der vorgenannten Produkte und Dienstleistungen der vorgenannten Unternehmen und Marktforschung genutzt werden.
Meine Einwilligung umfasst zudem die Verarbeitung meiner E-Mail-Adresse und Telefonnummer für den Datenabgleich zu Marketingzwecken mit ausgewählten Werbepartnern wie z.B. LinkedIN, Google und Meta. Hierfür darf die Vogel Communications Group die genannten Daten gehasht an Werbepartner übermitteln, die diese Daten dann nutzen, um feststellen zu können, ob ich ebenfalls Mitglied auf den besagten Werbepartnerportalen bin. Die Vogel Communications Group nutzt diese Funktion zu Zwecken des Retargeting (Upselling, Crossselling und Kundenbindung), der Generierung von sog. Lookalike Audiences zur Neukundengewinnung und als Ausschlussgrundlage für laufende Werbekampagnen. Weitere Informationen kann ich dem Abschnitt „Datenabgleich zu Marketingzwecken“ in der Datenschutzerklärung entnehmen.
Falls ich im Internet auf Portalen der Vogel Communications Group einschließlich deren mit ihr im Sinne der §§ 15 ff. AktG verbundenen Unternehmen geschützte Inhalte abrufe, muss ich mich mit weiteren Daten für den Zugang zu diesen Inhalten registrieren. Im Gegenzug für diesen gebührenlosen Zugang zu redaktionellen Inhalten dürfen meine Daten im Sinne dieser Einwilligung für die hier genannten Zwecke verwendet werden.
Recht auf Widerruf
Mir ist bewusst, dass ich diese Einwilligung jederzeit für die Zukunft widerrufen kann. Durch meinen Widerruf wird die Rechtmäßigkeit der aufgrund meiner Einwilligung bis zum Widerruf erfolgten Verarbeitung nicht berührt. Um meinen Widerruf zu erklären, kann ich als eine Möglichkeit das unter https://kontakt.vogel.de/de/win abrufbare Kontaktformular nutzen. Sofern ich einzelne von mir abonnierte Newsletter nicht mehr erhalten möchte, kann ich darüber hinaus auch den am Ende eines Newsletters eingebundenen Abmeldelink anklicken. Weitere Informationen zu meinem Widerrufsrecht und dessen Ausübung sowie zu den Folgen meines Widerrufs finde ich in der Datenschutzerklärung, Abschnitt Redaktionelle Newsletter.
Damit wird Ownership bei KI zur Frage nach der lückenlosen Rechte- und Herkunftskette für die Bestandteile eines KI-Systems – zur Chain-of-Title-Frage. Ein industrielles System kann auf einem chinesischen Foundation Model basieren, Open-Source-Komponenten enthalten, mit europäischen Unternehmensdaten fine-getuned und in Europa eingesetzt werden. Auf jeder Stufe können Rechte entstehen oder verletzt werden. Notwendig ist eine AI-IP-Chain-of-Title, eine lückenlose Rechte- und Herkunftskette für Trainingsdaten, Basismodell, Weights, Fine-Tuning-Daten, Adapter und Output. Sie klärt Herkunft, Lizenzen, Nutzungsrechte und Dritt-IP-Risiken.
Parallel vollzieht China den Wandel vom Datensammeln zur Data Asset Economy. Generative-AI-Regeln verlangen in ihrem jeweiligen Anwendungsbereich rechtmäßige Trainingsdaten. Das Wettbewerbsrecht schützt Unternehmensdaten unter bestimmten Voraussetzungen gegen unlauteres Abschöpfen, das Geschäftsgeheimnisrecht wertvolle nichtöffentliche Datensätze und das Datenschutzrecht personenbezogene Informationen. China schafft damit kein umfassendes Eigentum an Daten, aber ein zunehmend differenziertes System wirtschaftlicher Kontroll- und Nutzungsrechte.
Für europäische Unternehmen ist die Frage „Wem gehören die Daten?“ deshalb zu kurz gegriffen. Entscheidend ist vielmehr: Wer darf welche Daten für welchen Zweck nutzen, trainieren, kombinieren, weitergeben und monetarisieren – und wem gehört der daraus entstehende Mehrwert? Verträge mit chinesischen KI-Anbietern sollten Input- und Trainingsdaten, Prompts, Wissensdatenbanken, feinabgestimmte Modelle, Adapter, Gewichte und Outputs ausdrücklich erfassen. Wichtig sind zudem Verbote der Weiterverwendung vertraulicher Daten für allgemeines Modelltraining, Löschungs- und Rückgabepflichten, Audit-Rechte zur Herkunft fremder Trainingsdaten sowie Freistellungen bei Dritt-IP-Verletzungen.
Die entscheidende wirtschaftliche Frage lautet damit nicht mehr nur, welches Modell leistungsfähiger ist. Entscheidend ist, wer die Daten kontrolliert, aus denen diese Leistungsfähigkeit entsteht – und wer den daraus geschaffenen Wert anschließend abschöpft. KI ist für die Beantwortung dieser Frage geradezu prädestiniert, weil sie die fragmentierte IP-Lage eines KI-Systems in eine nachvollziehbare Rechte- und Risikostruktur übersetzen kann. Sie ersetzt dabei nicht die juristische Bewertung durch den IP-Berater, übernimmt aber vor allem Strukturierung, Dokumentenanalyse, Konsistenzprüfung und die Ableitung möglicher Handlungsoptionen.
Dr. Lili Yang ist Senior Consultant bei der Chinabrand IP Consulting GmbH.
Bildquelle: Chinabrand
Chang Luo ist Consultant bei bei der Chinabrand IP Consulting GmbH.